Ces derniers mois, vous avez sûrement vu passer les mots « serverless » ou « FaaS » (Function as a Service), en vous demandant : « Bon, simple effet de mode, ou il y a vraiment quelque chose à y gagner ? »
Je vous propose un retour d’expérience sur un cas concret, rencontré dans l’entreprise où je travaille : il montre pourquoi le passage au serverless nous a permis de répondre au besoin.
Pour y arriver, nous avons utilisé les produits, frameworks et bibliothèques suivants :
- Symfony (PHP)
- Bref.sh
- Serverless Framework
- Browsershot
- Puppeteer
- Amazon SQS
- Amazon Lambda
- Scaleway S3
Mon équipe travaille avec PHP7, Symfony et Vue.js.
Une coquille ou une erreur dans la version originale ? Vous pouvez contribuer à cet article en proposant une pull request.
Le besoin : générer des rapports statistiques en PDF
Voici les user stories :
- « En tant que client du CMS, je dois recevoir chaque mois un rapport PDF contenant plusieurs statistiques sur mon site web »
- « En tant que revendeur de ce groupe de clients du CMS, je dois recevoir chaque mois un rapport PDF qui reprend les rapports de chacun de mes clients (une partie de chacun) »
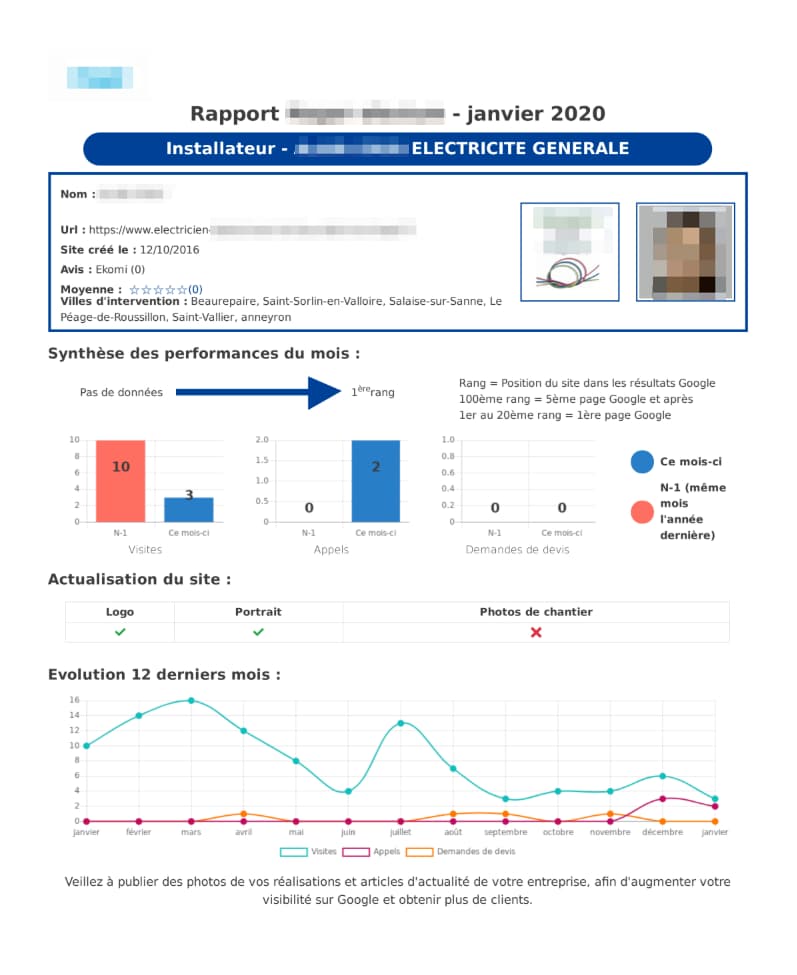
Concrètement, pour les quelques clients qui disposent de cette fonctionnalité, cela fait plus de 2 000 PDF à générer. Voici à quoi ressemble l’un des PDF à générer :
L’option VPS ou serveur dédié
Vous pourriez mettre en place une tâche cron sur l’un de vos serveurs, qui se chargerait de lancer une commande pour générer les PDF. Le principal problème : ça ne passe pas à l’échelle.
~20 secondes (génération d’un PDF) x 2 000 PDF = 11 heures de génération de PDF
La génération prend 2 secondes en moyenne, mais un PDF lourd, qui contient plusieurs pages de plusieurs rapports, peut demander jusqu’à 30 secondes.
Pendant ces 11 heures, il vous faudrait garantir que la génération tienne la distance (déploiements de l’application, redémarrages du serveur, etc.), et disposer d’un moyen de vérifier que le processus tourne toujours, par exemple avec Supervisor.
Il vous faudrait aussi écrire tout le processus en « programmation défensive », pour que votre code continue de fonctionner face aux imprévus.
Comme notre application est en PHP, elle n’est pas multithread : impossible de tirer facilement parti de tous les cœurs CPU de notre serveur dédié. Pour paralléliser, l’une des solutions consiste à louer davantage de serveurs, qu’il faut ensuite déployer, provisionner et administrer.
L’option serverless
Voici comment s’enchaînent les étapes de notre architecture.
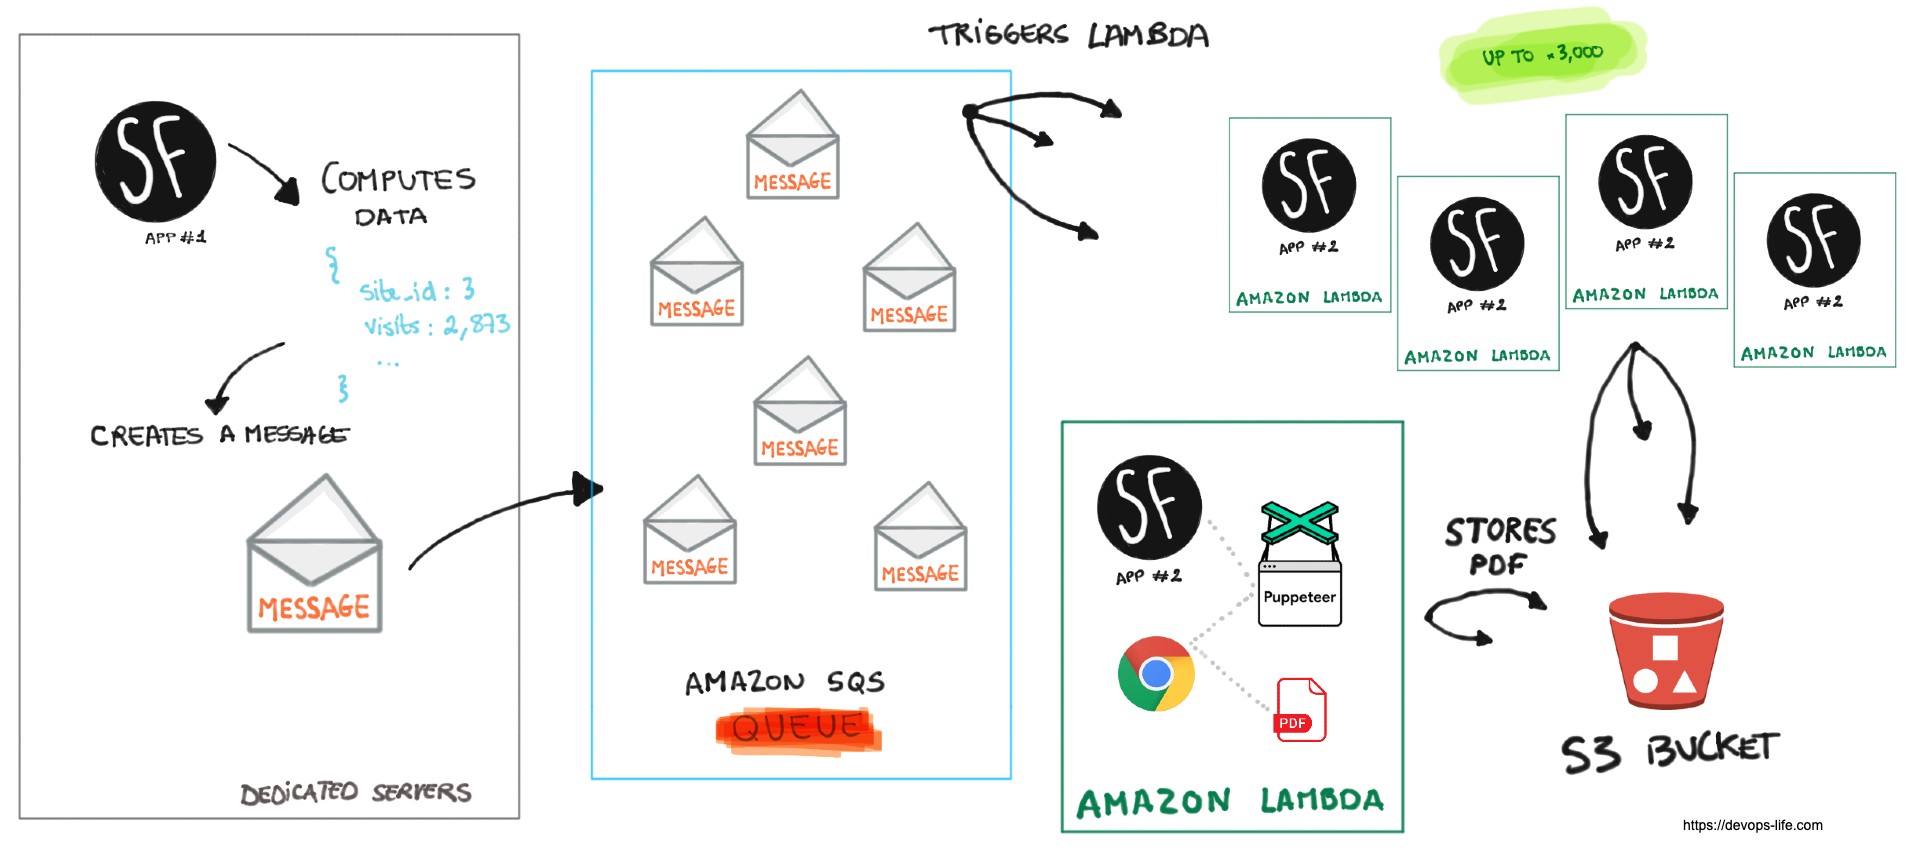
L’architecture serverless en Full HD.
Étape 1 : préparer les données
Comme ce PDF agrège de nombreuses données, internes et externes, mieux vaut avoir les données prêtes au moment de le générer. L’application CMS (app #1, PHP/Symfony) se charge de rassembler et de stocker dans une instance Redis toutes les données nécessaires à la construction du PDF.
Puisque l’on vise la scalabilité, il ne faut pas que le service chargé de générer les PDF aille demander les données à app #1 via une API : elle deviendrait un goulot d’étranglement si 3 000 lambdas lui envoyaient des requêtes en même temps.
Étape 2 : créer des messages asynchrones
Une fois toutes les données prêtes, app #1 les met en forme dans un message, qu’elle glisse dans une enveloppe avec Symfony Messenger pour envoyer les messages dans une file Amazon SQS.
Remarque pour les utilisateurs de Symfony : comme les messages seront lus par une autre application (Symfony, elle aussi), vous devez utiliser un sérialiseur de messages personnalisé. Pour en savoir plus, lisez la RFC que j’ai ouverte sur le dépôt de Symfony.
Étape 3 : stocker les messages dans une file d’attente
Dès que les messages arrivent dans la file Amazon SQS, ils déclenchent notre lambda, qui exécute notre code de génération des PDF.
Remarque : la structure de nos messages (un Plain Old PHP Object) est stockée dans un autre dépôt git. Pourquoi ? Parce que app #1 et app #2 ont toutes les deux besoin de ce POPO. Qu’un développeur modifie la structure du message dans app #1 en oubliant de le faire dans app #2, c’était un risque inutile.
Étape 4 : générer les PDF
Jusqu’à 3 000 instances de lambda sont démarrées : là, on parle de scalabilité sérieuse (dans notre cas, nous nous sommes limités à 50 lambdas simultanées). Chaque lambda reçoit un message qui contient les données nécessaires pour générer 1 PDF.
La lambda exécute ensuite notre app #2 (PHP, Symfony), chargée d’afficher une vue dans une page web à partir de simples templates .twig, avec un peu de JavaScript pour dessiner les graphiques.
Le code utilise ensuite Browsershot, qui transforme une page web en PDF : un Chrome headless, piloté par Puppeteer, visite l’URL qui affiche le template .twig, lequel deviendra notre PDF.
Une fois généré, le PDF est stocké dans un bucket S3.
Nous avons utilisé Bref.sh autour de Symfony. C’est génial : Bref intègre votre framework PHP préféré aux lambdas, et fournit différents runtimes PHP qui tourneront sur la lambda.
Les 2 000 PDF sont tous générés en 2 minutes
Étape 5 : envoyer le PDF au client par e-mail
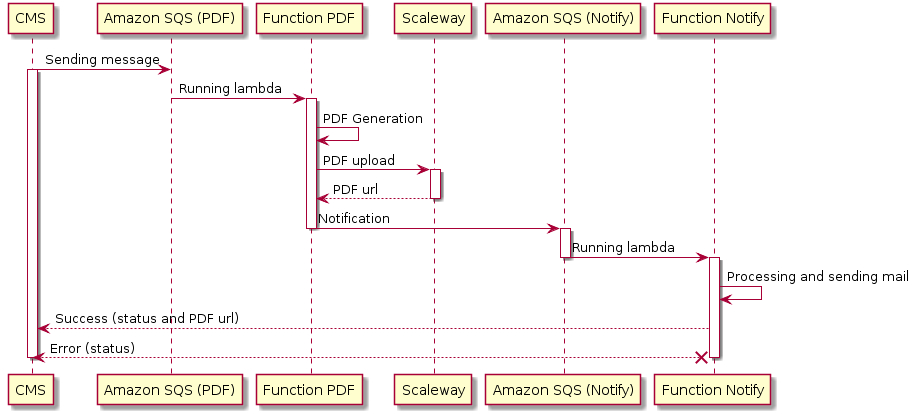
Le schéma d’architecture ne montre qu’une partie de ce qui se passe réellement. Une fois le PDF généré dans le bucket, nous créons un nouveau message, que nous envoyons dans une autre file SQS. Cette file-là fait de nouveau appel à app #2 (mais à une autre partie du code) pour envoyer au client un e-mail avec le PDF en pièce jointe, et pour prévenir l’application CMS : les clients peuvent ainsi télécharger leur PDF depuis le back-office, eux aussi.
Comparatif
| VPS ou serveur dédié | Serverless | |
|---|---|---|
| Complexité | Faible | Moyenne |
| Coût | Élevé | Faible |
| Scalabilité | Complexe | Très scalable |
Conclusion
L’un des principaux avantages d’une architecture serverless, c’est que vous n’êtes facturé que pour le temps réellement nécessaire à l’exécution du code.
Vous n’avez pas non plus à vous soucier d’où ni de comment il tourne : vous livrez votre code, et il s’exécute dans le cloud. C’est le fournisseur cloud qui se charge d’allouer les ressources machine.
Dans notre exemple, avec l’offre gratuite d’Amazon Lambda et d’Amazon SQS, générer 2 000 PDF nous coûte ~1,63 $ (1,62 $ pour SQS, 0,01 $ pour Lambda). Pour affiner vos estimations, vous pouvez utiliser ce calculateur de coûts serverless.
Si vous pensez qu’une partie de votre code gagnerait à passer sur une architecture serverless, je vous conseille de commencer par un POC très simple, pour vous familiariser avec ces nouveaux concepts. C’est ce que nous avons fait avec une petite portion de notre code, avant même de nous attaquer au problème des PDF, pour mieux comprendre tout l’écosystème (files d’attente, lambdas, notifications…). Nous avons aujourd’hui 5 lambdas, chacune chargée d’une tâche précise (en dehors des PDF).
Pour aller plus loin, sous un angle plus technique : Generate PDFs on Amazon AWS with PHP and Puppeteer, écrit par Hugo Alliaume, qui nous a beaucoup aidés sur ce sujet. Vous y trouverez de nombreux détails, comme la façon dont nous avons embarqué Chrome dans la lambda.